Devolver una tabla entera en una sola respuesta funciona hasta que la tabla crece. Con 100.000 productos, un GET /productos sin límite significa megabytes de JSON, segundos de espera y un cliente que probablemente solo quería ver los 20 primeros. Paginar es obligatorio en cualquier listado que pueda crecer — la pregunta interesante es cómo, porque la forma más intuitiva de hacerlo tiene un problema de rendimiento que no se ve hasta que ya está en producción.
Paginación por offset: la intuitiva
Es la que sale sola: el cliente pide una página y un tamaño, y la API lo traduce a SQL directamente.
GET /productos?page=3&per_page=20SELECT * FROM productos
ORDER BY creado_en DESC
LIMIT 20 OFFSET 40;Tiene ventajas reales: es trivial de implementar, permite saltar a cualquier página («ir a la página 14»), y calcular el total de páginas es un COUNT. Para tablas pequeñas o interfaces de administración, es perfectamente válida.
El problema: OFFSET no salta, recorre
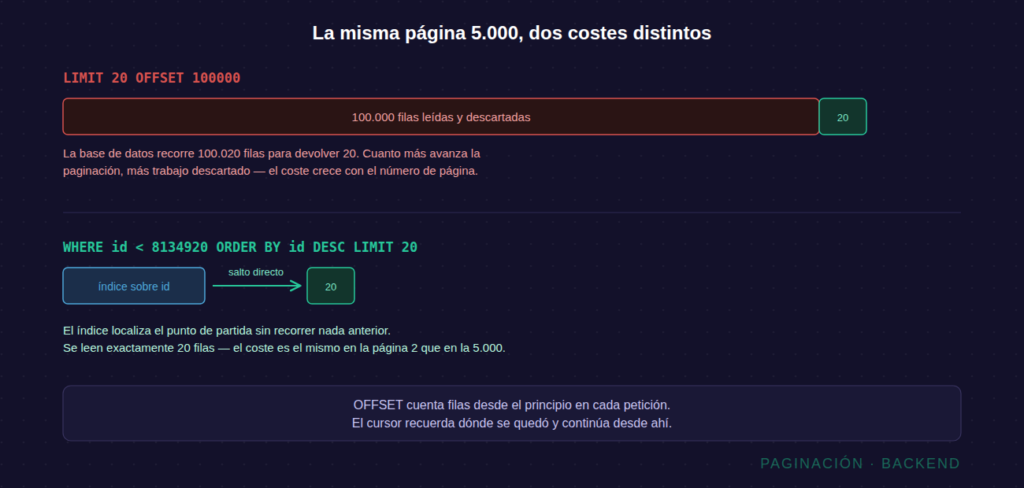
OFFSET 100000 no le dice a la base de datos «empieza en la fila 100.000»: le dice «lee 100.020 filas ordenadas y tira las 100.000 primeras». No existe un atajo para saber dónde empieza la fila 100.001 sin contar todas las anteriores. El resultado es que el coste de cada página crece con el número de página: la página 2 es instantánea y la página 5.000 tarda segundos, sobre exactamente los mismos datos.
Hay un segundo problema más sutil: la deriva de resultados. Si entre la petición de la página 1 y la de la página 2 se inserta un producto nuevo al principio del orden, todo se desplaza una posición — y el último elemento de la página 1 reaparece como primero de la página 2. En un listado que cambia con frecuencia (un feed, un historial de movimientos), el usuario ve duplicados o se salta elementos sin saberlo.
Paginación por cursor: recordar dónde te quedaste
La alternativa — también llamada keyset pagination — cambia la pregunta. En vez de «dame la página 3», el cliente pide «dame lo que viene después del último elemento que ya tengo». Ese «último elemento» es el cursor.
-- el cliente vio hasta el producto con id 8134920
SELECT * FROM productos
WHERE id < 8134920
ORDER BY id DESC
LIMIT 20;
Con un índice sobre id, la base de datos localiza el punto de partida de un salto y lee exactamente 20 filas. El coste es idéntico en la página 2 y en la 5.000. Y la deriva desaparece: aunque se inserten filas nuevas por delante, «lo que viene después del id 8134920» sigue siendo lo mismo.
Cómo se ve en la API
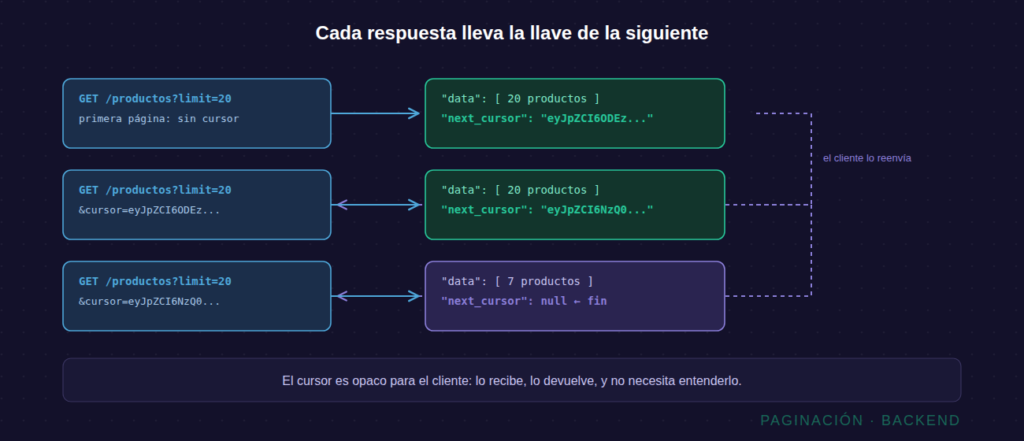
El servidor incluye en cada respuesta un cursor que apunta al final de la página devuelta, y el cliente lo reenvía tal cual para pedir la siguiente:
{
  "data": [ ... 20 productos ... ],
  "next_cursor": "eyJpZCI6ODEzNDkyMH0"
}
El cursor suele ser el valor de ordenación codificado en Base64 — en este caso, {"id":8134920}. La codificación no es seguridad: es una señal de contrato. Un cursor opaco le dice al cliente «recibe esto y devuélvelo, no lo construyas tú», lo que te deja libertad para cambiar su contenido interno (añadir un segundo campo de ordenación, por ejemplo) sin romper a nadie.
Un detalle que importa en cuanto ordenas por algo que no es único: si ordenas por creado_en y dos filas comparten el mismo instante, el cursor no sabe cuál de las dos fue la última. La solución estándar es un desempate con la clave primaria — ordenar por (creado_en, id) y comparar por ambos:
SELECT * FROM productos
WHERE (creado_en, id) < ('2026-07-01 10:32:00', 8134920)
ORDER BY creado_en DESC, id DESC
LIMIT 20;
Qué pierdes con el cursor
- No hay acceso aleatorio: no puedes saltar a la página 14 sin haber recorrido las 13 anteriores. Para interfaces con números de página visibles, offset sigue siendo la opción natural.
- Retroceder requiere trabajo extra: hace falta un
prev_cursory una consulta con el orden invertido, o que el cliente conserve los cursores por los que ya pasó. - El total deja de ser gratis: «mostrando 20 de 84.312» exige un
COUNTaparte — que sobre tablas grandes tiene su propio coste.
Cuál elegir
- Offset: tablas acotadas, paneles de administración, interfaces con números de página, y en general cualquier caso donde nadie pasará de las primeras decenas de páginas.
- Cursor: scroll infinito, feeds, historiales, exportaciones, APIs públicas consumidas por scripts — cualquier listado grande que se recorre secuencialmente.
La mayoría de las APIs grandes (GitHub, Stripe, Slack) migraron de offset a cursor por exactamente los problemas de arriba, y varias mantienen ambos: offset para listados pequeños, cursor para los que crecen sin límite.
Paginar resuelve el problema de las respuestas grandes cuando son inmediatas. Pero hay operaciones que no deberían responderse de inmediato en absoluto — generar un informe pesado, procesar un vídeo — y para esas el patrón es otro: aceptar el trabajo, encolarlo, y hacerlo cuando toque.