Un usuario pulsa «Generar informe» y tu endpoint tarda 40 segundos en responder, porque generar el informe tarda 40 segundos. Durante ese tiempo, la conexión HTTP está abierta, un worker del servidor web está ocupado, y el usuario mira una rueda de carga preguntándose si algo se ha roto. El error de diseño no está en que el informe sea lento — está en haber acoplado la petición HTTP a un trabajo que no necesita terminar dentro de ella.
Separar aceptar de procesar
Una cola de mensajes es un buffer intermedio entre quien pide un trabajo y quien lo ejecuta. La API deja de hacer el trabajo pesado: lo describe en un mensaje, lo deposita en la cola y responde de inmediato. Otro proceso — un worker — consume la cola a su ritmo y hace el trabajo real.
Los tres roles tienen nombre propio:
- Productor: quien publica mensajes en la cola. Típicamente tu API, al recibir una petición que implica trabajo pesado.
- Cola (broker): quien guarda los mensajes de forma duradera hasta que alguien los procese. RabbitMQ, Amazon SQS o Redis (con streams) son los habituales.
- Consumidor: los workers que extraen mensajes y ejecutan el trabajo. Puede haber uno o cientos, y escalan de forma independiente de la API.
La respuesta HTTP correcta para este patrón es 202 Accepted — «he aceptado el encargo», que no es lo mismo que «lo he hecho» — normalmente acompañada de una URL donde consultar el estado:
POST /informes
→ 202 Accepted
{
  "job_id": "9f31ab",
  "status_url": "/informes/9f31ab/estado"
}
Qué compra este desacoplo
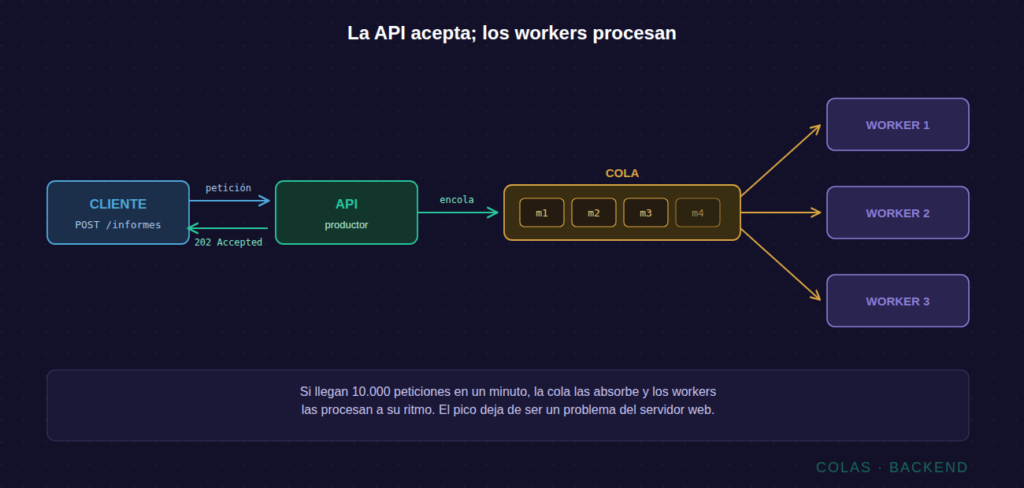
- Absorción de picos: si llegan 10.000 peticiones en un minuto, la cola las acumula y los workers las procesan a su velocidad. El pico deja de tumbar al servidor web: se convierte en una cola más larga durante un rato.
- Resistencia a fallos: si el worker se cae a mitad de un trabajo, el mensaje no se pierde — otro worker lo retomará. Si se cae el servicio de emails del que depende el worker, los mensajes esperan en la cola hasta que vuelva.
- Escalado independiente: ¿la cola crece más rápido de lo que se vacía? Añades workers, sin tocar la API. Son procesos separados con vidas separadas.
- Desacoplamiento temporal: el productor y el consumidor no necesitan estar vivos a la vez. La API puede encolar trabajos a las 3 de la mañana aunque los workers de facturación solo corran en horario de oficina.
El ciclo de vida de un mensaje
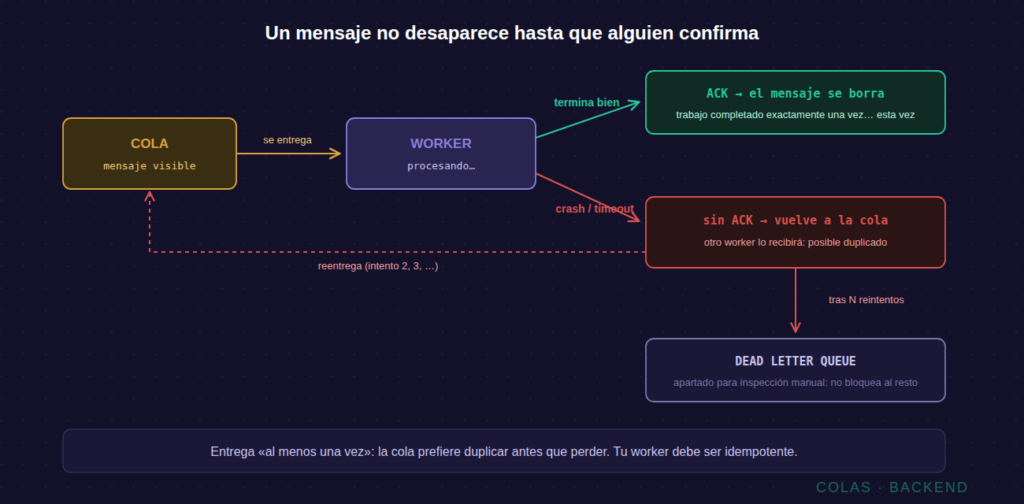
La pieza que hace fiable todo el sistema es el acknowledgement (ack). Cuando la cola entrega un mensaje a un worker, no lo borra: lo marca como invisible y espera. Solo cuando el worker confirma explícitamente que terminó — el ack — el mensaje se elimina de verdad. Si el worker muere a mitad, o tarda más de un tiempo límite, la cola asume que algo fue mal y vuelve a hacer visible el mensaje para que otro worker lo intente.
Este diseño tiene una consecuencia que conviene entender antes de que te sorprenda en producción: la garantía habitual es at-least-once (al menos una vez). Si un worker procesa el mensaje entero pero muere justo antes de enviar el ack, la cola no puede distinguirlo de un fallo real — y reentrega el mensaje. El trabajo se ejecuta dos veces.
La cola prefiere duplicar antes que perder, y es la elección correcta. Pero traslada una obligación a tu código: el worker debe ser idempotente — procesar el mismo mensaje dos veces tiene que dejar el sistema igual que procesarlo una. La técnica es la misma de siempre: cada mensaje lleva un identificador único, y el worker registra los que ya procesó para reconocer un duplicado y descartarlo sin efectos.
Dead letter queue: el mensaje que nunca sale bien
¿Y si un mensaje falla siempre? Un JSON mal formado, un pedido que referencia un producto borrado — reintentarlo eternamente solo consigue que un worker pierda el tiempo en bucle. La solución estándar es la dead letter queue (DLQ): tras N intentos fallidos, el broker aparta el mensaje a una cola secundaria donde no molesta, y el flujo principal sigue limpio. La DLQ se revisa aparte — con una alerta cuando deja de estar vacía, porque cada mensaje ahí dentro es un bug o un caso no contemplado esperando a que alguien lo mire.
Cuándo NO usar una cola
- Cuando el cliente necesita el resultado en la respuesta: un login, una búsqueda, un cálculo de precio. Encolar algo que el usuario espera de forma síncrona solo añade latencia y complejidad.
- Cuando el volumen no lo justifica: una tarea rápida que ocurre diez veces al día no necesita un broker; un proceso en segundo plano del propio framework llega de sobra.
- Cuando aún no puedes operar la pieza extra: un broker es infraestructura que hay que desplegar, monitorizar y mantener. Es un intercambio: resiliencia a cambio de complejidad operativa.
Los candidatos naturales son los de siempre: envío de emails y notificaciones, generación de informes y exportaciones, procesamiento de imágenes y vídeo, sincronizaciones con servicios externos lentos. Todo lo que el usuario no necesita ver terminado para seguir con su vida.
Queda un cabo del patrón: cuando el trabajo encolado finalmente falla de forma definitiva, o cuando la propia API rechaza una petición, ¿qué recibe exactamente el cliente? Resulta que la mayoría de las APIs cuidan mucho sus respuestas correctas y improvisan las de error — y eso también tiene solución estándar.